图片与语音
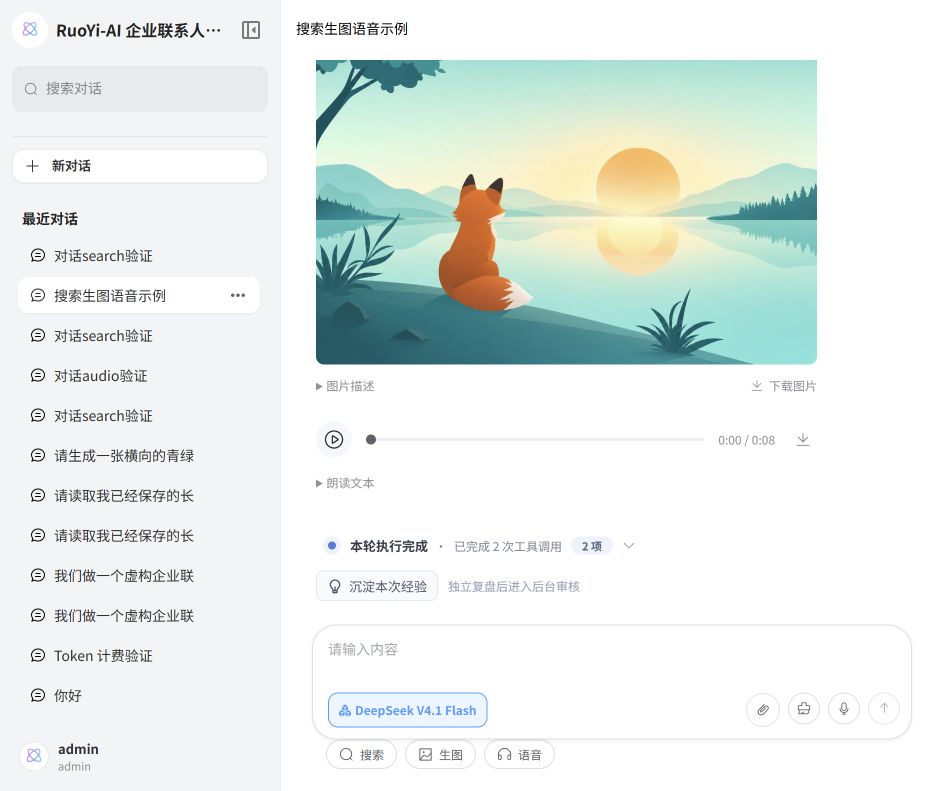
在输入区域选择生图或语音,复用已有模型与个人密钥配置。生成图片直接展示,语音支持播放、暂停、进度拖动和时间显示。
图片生成
开始之前
在模型管理中配置图片类别模型并启用展示,在工具管理中启用图片生成。使用智能体时,绑定图片生成工具。模型与个人密钥沿用现有配置入口。
本页示例使用 Atlas Cloud 接入的 openai/gpt-image-2/text-to-image。其他模型是否可用,以当前配置与服务商支持为准。
操作步骤
- 打开会话,在输入区域选择生图。
- 选择可用的图片模型及尺寸。
- 输入主题、画面内容、风格和构图,发送需求。
- 等待生成完成。图片会直接显示在回复下方;点击图片可放大,使用下载入口保存。
可直接使用的需求
text
生成一张青绿色极简插画:一只橙色狐狸坐在湖边看日出。
画面干净,留白充足,不要文字,横版构图。
使用建议
- 把“主体、场景、风格、比例、是否需要文字”写清楚,更容易得到符合要求的画面。
- 生成是异步任务。提交成功后等待结果即可,避免重复发送同一任务。
- 结果保存在会话中,重新打开会话仍可预览与下载。
- 如果提示生成失败,检查模型、访问密钥、服务额度和参数后再试。
语音生成
将播报内容写进对话,生成后即可播放和下载。播放器与回复放在一起,支持播放、暂停、进度拖动及时间显示。
配置与操作
- 在模型管理配置语音类别模型,在工具管理启用语音生成;使用智能体时绑定该工具。
- 打开会话,在输入区域选择语音,选择可用模型与声音参数。
- 输入需要朗读的原文,发送后等待生成。
- 点击播放按钮试听,拖动进度条定位;通过下载入口保存音频。
本页示例使用 Atlas Cloud 接入的 bytedance/seed-audio-1.0。声音、格式等参数以所选服务支持为准。
可直接使用的需求
text
请生成语音,朗读以下内容:
欢迎使用若依智能助手。搜索、图片生成和语音播放,
现在可以在对话中完成。
试听与交付
- 浏览器不会自动播放声音,请点击播放按钮开始试听。
- 朗读内容应直接提供完整文本;专有名词和数字可补充读法要求。
- 历史会话可以再次播放;下载文件可用于演示、培训或播报。
- 如音频未加载,先确认任务完成,再检查登录状态与模型服务。
效果示例
模型选择以后台配置与服务商支持为准,访问密钥仅填写在模型配置入口。